Когда хочется поработать с большой языковой моделью без постоянной отправки запросов в облако, первый вопрос обычно очень практичный: потянет ли это домашний ПК и с чего вообще начать. Локальный запуск Llama интересен не только энтузиастам, но и тем, кто не хочет передавать тексты на сторонний сервер, зависит от интернета или просто хочет получить быстрый офлайн-доступ к модели.
У этой идеи есть и обратная сторона: локальный запуск Llama сильно зависит от видеокарты, объема памяти, формата модели и выбранной программы для запуска. Ниже разберем, на каком компьютере это имеет смысл, чем отличаются способы установки и где пользователи чаще всего ошибаются, когда пытаются организовать запуск нейросети локально впервые.
Почему локальный запуск Llama стал реальной задачей для обычного ПК
Еще недавно работа с языковыми моделями дома выглядела как занятие для владельцев дорогих рабочих станций. Сейчас ситуация изменилась. Появились компактные квантизованные версии моделей, а вместе с ними и инструменты, которые снимают часть технической сложности. Из-за этого локальный запуск Llama перестал быть сугубо лабораторной историей и стал нормальным пользовательским сценарием для тех, у кого есть современный настольный компьютер или ноутбук с достаточным объемом оперативной памяти.
Главный мотив почти всегда один и тот же: приватность. Если вы анализируете личные заметки, рабочие тексты, фрагменты кода или внутренние документы, передавать их на внешний сервис удобно не всем. В таком режиме локальный запуск Llama дает понятное преимущество: данные обрабатываются на вашем устройстве. Это не отменяет базовых правил безопасности, но заметно сокращает круг внешних рисков.
Есть и вторая причина, не менее приземленная. Облачные сервисы могут менять тарифы, ограничивать число запросов, тормозить в часы нагрузки или требовать постоянного входа в аккаунт. Когда нужен стабильный инструмент под рукой, запуск нейросети локально часто оказывается предсказуемее. Особенно если вы используете модель регулярно, а не от случая к случаю.
При этом важно не романтизировать тему. Локальный запуск Llama не делает любой компьютер машиной для мгновенной генерации. Скорость ответа зависит от того, идет ли вычисление на CPU или GPU, сколько слоев модели выгружено на видеокарту, насколько агрессивно выполнена квантизация и не упирается ли система в медленный накопитель. Если ожидания завышены, первое впечатление от локальной модели бывает разочаровывающим.
Какой компьютер подходит для локального запуска Llama без лишних ожиданий
Самая частая ошибка здесь не техническая, а оценочная: пользователь видит слово «локально» и предполагает, что подойдет любой офисный ноутбук. На практике локальный запуск Llama возможен в очень разных конфигурациях, но качество опыта будет отличаться радикально. На слабом процессоре без дискретной графики модель может работать, но отвечать заметно медленнее, особенно на длинных запросах.
Если ориентироваться на бытовой сценарий, решают три ресурса: оперативная память, объем видеопамяти и пропускная способность системы хранения. Для компактных квантизованных моделей достаточно умеренной конфигурации, но как только вы хотите более длинный контекст, выше скорость или крупную модель, требования растут. Особенно чувствительна к этому установка Llama на ПК без видеокарты: модель можно запустить через процессор, однако время отклика становится главным ограничением.
Для Windows имеет значение и сама среда. Антивирусная проверка больших файлов моделей, индексирование папок и фоновая нагрузка могут мешать не меньше, чем слабый процессор. Если компьютер уже работает на пределе из-за браузера, мессенджеров и десятка фоновых служб, локальный запуск Llama будет казаться медленным даже с нормальным железом. Поэтому перед установкой полезно оценить не только характеристики, но и текущее состояние системы. Если Windows давно не обслуживалась, может пригодиться раздел с практическими советами и компьютерные лайфхаки по базовой оптимизации без рискованных твиков.
Ноутбуки здесь ведут себя особенно по-разному. Две модели с похожими характеристиками на бумаге могут давать разный результат из-за лимитов питания, температуры и качества охлаждения. Длительная генерация текста нагружает систему не так, как короткий офисный сценарий, и троттлинг быстро проявляет слабые места корпуса. Поэтому для ноутбука важно смотреть не только на объем памяти, но и на то, как устройство держит длительную нагрузку. Если речь идет о выборе новой машины под подобные задачи, полезно учитывать материалы по категории ноутбуки, где обычно разбирают охлаждение, апгрейд и ограничения мобильных платформ.
На практике можно ориентироваться на такие признаки, что конфигурация хотя бы подходит для старта:
- есть не менее 16 ГБ оперативной памяти;
- система установлена на SSD, а не на старый HDD;
- дискретная видеокарта имеет достаточный запас видеопамяти для выбранной модели;
- Windows не перегружена фоновыми задачами и не испытывает дефицит памяти постоянно.
Это не универсальная формула, а здравый минимум для первых экспериментов. Если его нет, локальный запуск Llama все равно возможен, но тогда лучше сразу смотреть на самые компактные сборки моделей и спокойно принять более медленную генерацию.
Через что удобнее организовать локальный запуск Llama в Windows
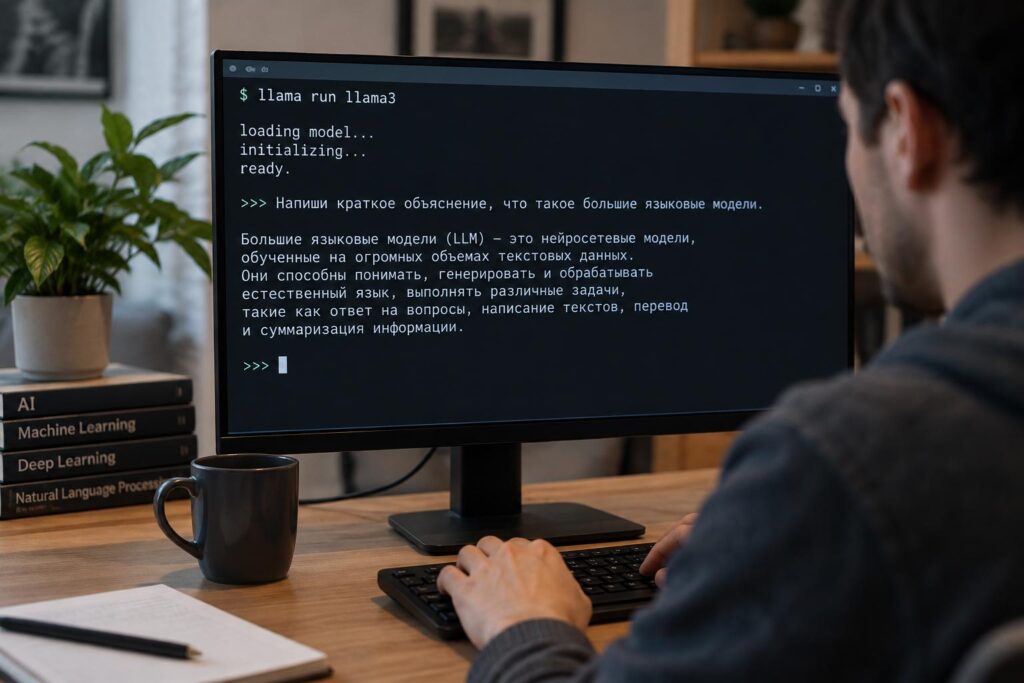
У пользователя есть несколько путей. Можно поднимать модель вручную через консольные проекты, можно использовать графические оболочки, а можно выбрать промежуточный вариант, где запуск упрощен, но контроль над моделями сохраняется. Для большинства домашних систем самым дружелюбным входом оказывается Ollama для Llama. Этот вариант ценят именно за то, что он убирает значительную часть рутинной настройки.
Идея простая: вы устанавливаете среду, которая управляет моделями, загружает их в нужном формате и дает понятный способ общения через терминал или совместимые интерфейсы. За счет этого локальный запуск Llama становится ближе к обычной установке программы, а не к сборке проекта из исходников. Для начинающего пользователя это часто лучший компромисс между простотой и контролем.
Важно лишь помнить, что Ollama для Llama не отменяет аппаратные ограничения. Если модель слишком тяжелая для вашей конфигурации, удобный менеджер не сделает ее быстрой. Он лишь снижает порог входа, помогает избежать путаницы с форматами и упрощает повседневное использование. Для многих это уже достаточно весомый аргумент.
Альтернатива в виде графических оболочек может быть приятнее визуально, но не всегда проще при диагностике ошибок. Когда что-то идет не так, консольный вывод часто полезнее красивого интерфейса. Поэтому локальный запуск Llama в Windows удобнее начинать с инструмента, который ясно показывает, что происходит: скачивается ли модель, хватает ли памяти, задействован ли GPU, не блокирует ли запуск система безопасности.
Если параллельно изучаете другие локальные и облачные инструменты для работы с ИИ, автоматизацией и API, имеет смысл сравнивать их уже в общем контексте категории IT-сервисы, а не только по рекламным обещаниям. Для домашнего запуска важнее совместимость, формат моделей и контроль над данными, чем громкие формулировки на лендинге.
Установка Llama на ПК: что подготовить до первой загрузки модели
Половина проблем возникает еще до первой команды. Пользователь скачивает первую попавшуюся сборку, не смотрит на объем файла, не понимает разницы между форматами и не проверяет, хватает ли свободного места на системном диске. В результате установка Llama на ПК прерывается, модель работает нестабильно или Windows начинает активно использовать файл подкачки, что резко снижает скорость.
До начала стоит проверить свободное место и решить, где будут храниться модели. Они занимают немало, а если вы экспериментируете с несколькими версиями и уровнями квантизации, папка быстро разрастается. Хранить ее лучше на SSD. Если модели лежат на медленном HDD, локальный запуск Llama может страдать уже на этапе загрузки и инициализации.
Отдельный вопрос касается драйверов видеокарты. Не нужно обновлять их бездумно перед каждым экспериментом, но слишком старый драйвер иногда приводит к тому, что ускорение не используется корректно. Здесь важна умеренность: скачивать драйверы стоит только с официального сайта NVIDIA, AMD или Intel, а перед крупным обновлением полезно создать точку восстановления системы.
Если компьютер рабочий, а не тестовый, разумно заранее продумать и вопрос резервного копирования. Сама установка Llama на ПК не относится к опасным операциям уровня прошивки BIOS или разметки диска, но большие загрузки, перенос системных папок и изменение переменных среды лучше делать аккуратно. Особенно если вы не уверены, как потом откатить настройки.
Подготовка обычно сводится к нескольким практическим вещам:
- Проверить свободное место на SSD и оставить запас под несколько моделей.
- Убедиться, что в системе достаточно ОЗУ и не висит постоянная нехватка памяти.
- Обновить драйвер видеокарты только при необходимости и только с официального источника.
- Выбрать один основной инструмент запуска, чтобы не смешивать несколько сред одновременно.
Этот порядок кажется скучным, но он экономит время. Когда локальный запуск Llama не удается с первой попытки, проблема часто не в модели, а в том, что пользователь одновременно пробует разные оболочки, разные папки хранения и несколько несовместимых способов запуска.
Локальный запуск Llama и выбор модели: размер, квантизация и скорость ответа
Самый заметный компромисс здесь связан не с интерфейсом, а с самой моделью. Один и тот же компьютер может давать приемлемую скорость на компактной квантизованной версии и почти не справляться с более крупной сборкой. Поэтому локальный запуск Llama лучше начинать не с максимального размера, а с модели, которую ваша система действительно может держать без постоянного обращения к подкачке.
Квантизация снижает точность хранения весов модели, чтобы уменьшить требования к памяти и упростить запуск. Для обычного пользователя это означает простую вещь: менее требовательная сборка почти всегда запускается легче, но в некоторых задачах может уступать более тяжелой версии по качеству ответа, устойчивости рассуждения или аккуратности формулировок. Разница зависит от конкретной модели и сценария: короткие бытовые вопросы переносят упрощение легче, чем работа с кодом, длинной логикой или терминологией.
Именно поэтому локальный запуск Llama не стоит оценивать по одному впечатлению от случайной модели. Если первая выбранная сборка работает медленно, это еще не означает, что идея в целом неудачна. Возможно, формат оказался слишком тяжелым для вашей видеокарты, а может быть, система запустила вычисления почти полностью на процессоре.
Полезно смотреть не только на размер модели, но и на длину контекста. Чем больше текста вы даете на вход и чем дольше ведете диалог, тем выше нагрузка на память и тем сильнее падает скорость. Для бытового режима это важнее, чем кажется. Пользователь может быть доволен первыми короткими ответами, а затем удивиться резкому замедлению после нескольких экранов переписки.
| Параметр | Что меняется на практике | На что влияет сильнее всего |
|---|---|---|
| Размер модели | Растет потребление памяти и нагрузка на GPU/CPU | Скорость и возможность запуска на текущем ПК |
| Уровень квантизации | Снижается объем модели, но возможны потери качества | Баланс между качеством ответа и требовательностью |
| Длина контекста | Увеличивается расход памяти при длинных диалогах | Стабильность и скорость в реальной работе |
| Запуск на CPU или GPU | GPU обычно дает заметно более быструю генерацию | Комфорт использования и время отклика |
Когда установка Llama на ПК уже выполнена, разумнее начать с умеренной модели, посмотреть на реальную скорость и только потом поднимать планку. Такой подход дает гораздо больше пользы, чем попытка сразу загрузить максимально крупную версию ради одной красивой характеристики.
Где локальный запуск Llama чаще всего дает сбой в реальном использовании
После успешной установки трудности никуда не исчезают. Локальный запуск Llama нередко упирается не в сам старт модели, а в повседневные детали. Пользователь открывает несколько тяжелых программ, оставляет десятки вкладок в браузере, включает модель с длинным контекстом и получает нестабильный отклик. Снаружи это выглядит как «модель тормозит», хотя проблема находится на уровне распределения ресурсов.
Очень частая история связана с памятью. Когда ОЗУ не хватает, Windows начинает активнее использовать файл подкачки на диске. Если диск медленный или уже занят фоновыми операциями, локальный запуск Llama резко теряет в скорости. На ноутбуках к этому добавляется снижение частот под нагрузкой и ограничения по питанию, особенно при работе от батареи.
Другой сбойный сценарий касается путаницы с ускорением на GPU. Пользователь уверен, что задействована видеокарта, а фактически значительная часть нагрузки идет через CPU. Это не всегда легко заметить без мониторинга, поэтому при первом запуске полезно проверить загрузку процессора, видеокарты и памяти в диспетчере задач. Для систем на Windows 11 и новых ПК с UEFI иногда имеют значение сопутствующие настройки платформы, драйверов и безопасности. Если вы параллельно разбираетесь с особенностями новой системы, часть материалов по теме есть в разделе Windows 11.
Иногда проблема вообще не в модели, а в безопасности Windows. Защитные механизмы могут дольше проверять крупные исполняемые файлы или архивы моделей. Отключать защиту ради ускорения не стоит. Безопаснее добавить доверенную рабочую папку только в том случае, если вы точно понимаете, что запускаете, и скачали файлы из официального или хорошо проверенного источника.
Есть и более прозаическая ошибка: люди ждут от локальной модели того же поведения, что от дорогого облачного сервиса с огромной серверной инфраструктурой. Локальный запуск Llama хорош там, где важны автономность, контроль над данными и базовая интерактивность. Если нужна очень высокая скорость на больших объемах, сложная обработка длинных документов или одновременная работа нескольких пользователей, домашний ПК может быстро упереться в потолок.
Когда запуск нейросети локально оправдан, а когда лучше выбрать облако
Запуск нейросети локально оправдан не по идеологическим причинам, а по практическим. Он хорошо подходит для личных заметок, черновиков, локального анализа текстов, экспериментов с промптами, базовой помощи в коде и задач, где нежелательно передавать данные вовне. В этих сценариях локальный запуск Llama дает понятимую выгоду: вы контролируете среду, не зависите от стабильности сервиса и не платите за каждый запрос как за отдельный ресурс.
Но у облака остаются сильные стороны. Если вам нужен максимум качества без настройки железа, постоянные обновления моделей, совместная работа команды или доступ с разных устройств, удаленный сервис удобнее. Домашний компьютер редко выигрывает у серверной инфраструктуры по общей производительности. Он выигрывает в другом: в независимости, офлайн-режиме и контроле.
Хороший ориентир здесь простой. Если вы готовы немного разобраться в форматах моделей, не боитесь консоли и хотите держать рабочие данные у себя, локальный запуск Llama вполне стоит усилий. Если же нужен результат без возни с памятью, драйверами и ограничениями железа, облачная платформа сэкономит время.
Многое зависит и от масштаба задач. Для любопытного пользователя установка Llama на ПК часто оказывается интересным и полезным опытом сама по себе. Для небольшой команды локальная схема может быть оправдана только при наличии человека, который умеет поддерживать среду и следить за обновлениями. В противном случае простая на вид автономность превращается в лишнюю техническую нагрузку.
В сухом остатке картина такая: локальный запуск Llama сегодня уже не выглядит экзотикой, но и не стал полностью бытовой кнопкой «включить». Лучше всего он раскрывается там, где есть достаточно памяти, SSD, внятное понимание ограничений модели и спокойное отношение к настройке. Если подойти к делу без завышенных ожиданий, выбрать умеренную модель и использовать удобный инструмент вроде Ollama для Llama, запуск нейросети локально дает именно то, что обещает: приватную и управляемую среду работы без постоянной зависимости от внешнего сервиса.
